Registre o sintoma, preserve as evidências e informe o impacto para facilitar a análise do suporte.
Os caminhos dos logs variam conforme a instalação. Preserve os registros do período da ocorrência. Se não souber onde encontrá-los, informe a versão e o componente afetado para receber orientação.
Descreva o resultado esperado e o observado, identifique os arquivos anexados e informe as verificações já realizadas. Não reinicie serviços apenas para tentar eliminar a mensagem antes de preservar as evidências e combinar a intervenção.
Consultar rotina de manutenção e suporte pós-entrega
Referência complementar para acompanhar a instalação após a entrega.
Após o deploy, o projeto entra em operação real. A partir desse momento, o integrador deve acompanhar a estabilidade do sistema, comunicação com máquinas, funcionamento do banco de dados, relatórios, backups, acesso Web, permissões, alarmes sistêmicos e desempenho geral do servidor.
- organizar rotina de suporte pós-entrega;
- acompanhar comunicação com máquinas;
- verificar saúde do servidor;
- monitorar banco de dados e espaço em disco;
- validar backups;
- revisar IIS e acesso Web;
- acompanhar alarmes sistêmicos;
- diagnosticar falhas recorrentes;
- registrar atendimentos;
- orientar operação e manutenção;
- estruturar plano de manutenção preventiva do supervisório.
O que é suporte pós-entrega
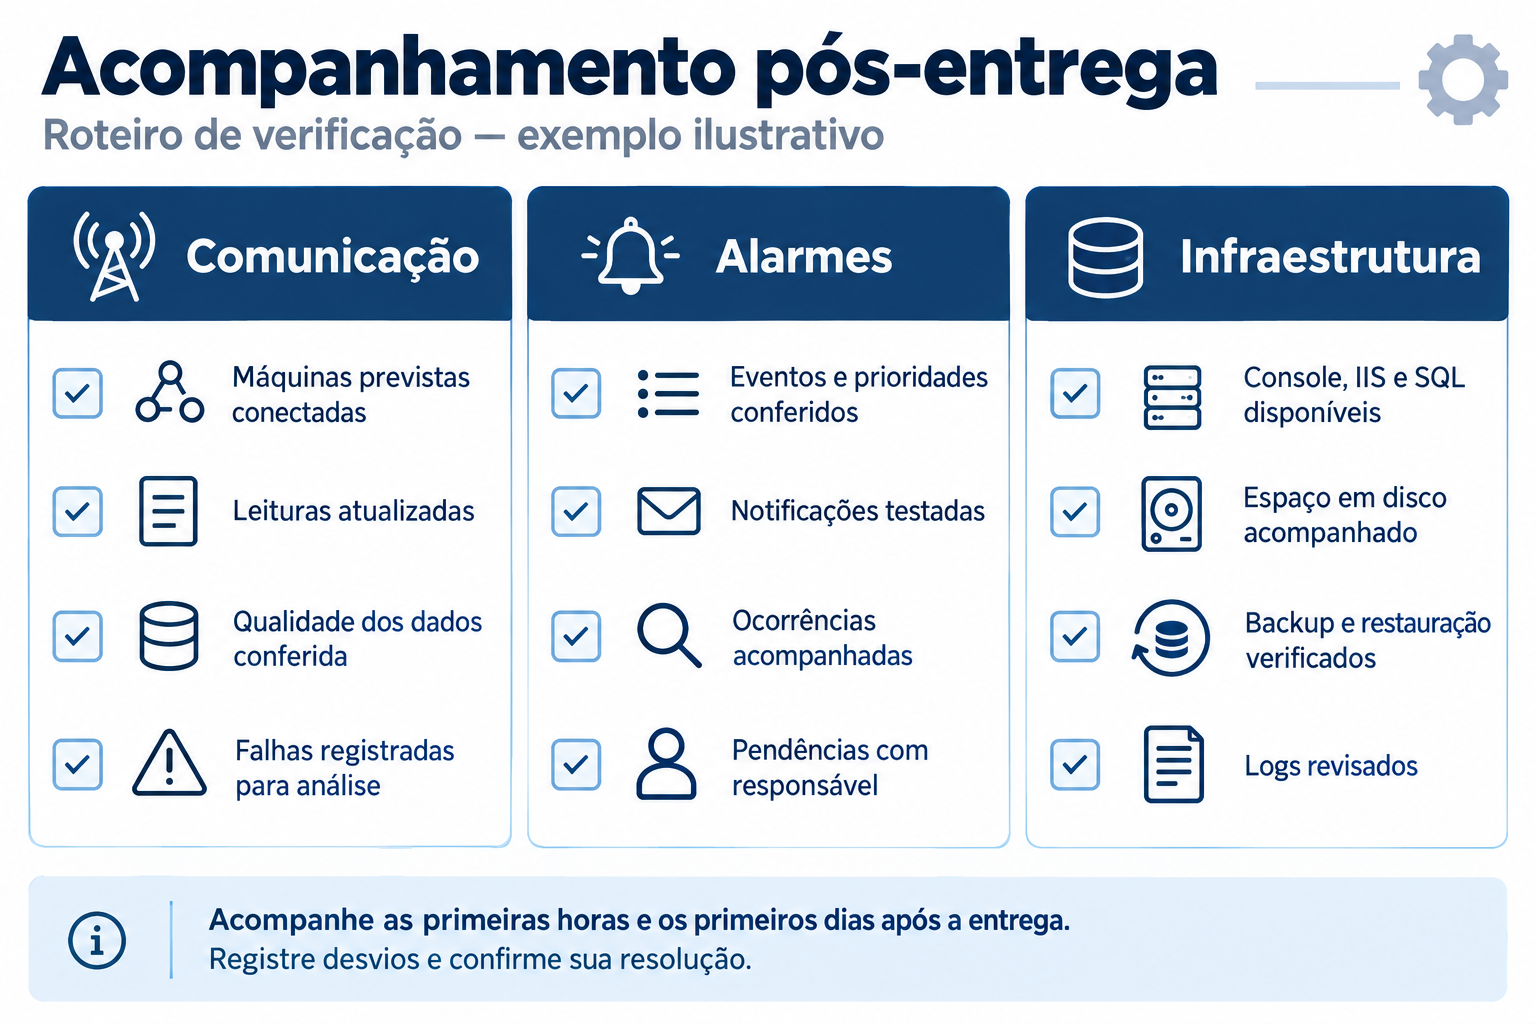 Figura 38.1 — Acompanhamento de operação pós-entrega.
Inclui:
Suporte pós-entrega é o conjunto de atividades realizadas após o sistema entrar em operação. (ver Figura 38.1).
- acompanhamento inicial;
- correção de pendências;
- resposta a falhas;
- análise de logs;
- monitoramento de comunicação;
- ajustes de telas;
- ajustes de relatórios;
- revisão de alarmes;
- orientação ao operador;
- backup periódico;
- atualização controlada;
- manutenção preventiva do servidor.
A entrega do projeto não termina quando a tela abre. Ela termina quando o sistema está estável, validado e a operação consegue utilizá-lo com segurança.
Período de acompanhamento inicial
Sugestão:
| Tipo de projeto | Acompanhamento inicial sugerido |
|---|
| Projeto pequeno | 1 a 3 dias |
| Projeto médio | 1 a 2 semanas |
| Projeto crítico | 2 a 4 semanas |
| Projeto com comandos remotos | acompanhamento assistido |
| Projeto com integração externa | acompanhamento até estabilização |
Após publicar o projeto, recomenda-se acompanhar o sistema por um período inicial.
Esse período pode variar conforme o porte do projeto.
Durante esse período, o integrador deve observar se os dados estão chegando corretamente, se os alarmes estão coerentes, se os relatórios são gerados e se os usuários conseguem operar o sistema.
Responsabilidades após entrega
| Atividade | Responsável sugerido |
|---|
| Operação diária | Cliente / operador |
| Verificação de alarmes | Operação |
| Manutenção do servidor | TI/OT do cliente ou integrador contratado |
| Ajustes de telas | Integrador |
| Ajustes de variáveis | Integrador / automação |
| Banco de dados | TI/OT / integrador |
| Backup | Cliente ou integrador, conforme contrato |
| Atualizações | Integrador |
| Comandos e lógica de campo | Automação / responsável técnico |
Defina claramente quem é responsável por cada item.
Essa definição evita dúvidas quando ocorre uma falha.
Rotina diária recomendada
Checklist diário:
| Item | Verificado |
|---|
| Supervisório acessível | ☐ |
| Login funcionando | ☐ |
| Tela inicial carregando | ☐ |
| Máquinas principais comunicando | ☐ |
| Alarmes ativos revisados | ☐ |
| Relatórios automáticos gerados | ☐ |
| Espaço em disco sem alerta | ☐ |
| Banco de dados acessível | ☐ |
| Backup recente confirmado, quando aplicável | ☐ |
| Acesso remoto funcionando, se usado | ☐ |
Em sistemas críticos, a operação ou suporte deve fazer verificações diárias.
A rotina diária deve ser simples, objetiva e rápida.
Rotina semanal recomendada
Checklist semanal:
| Item | Verificado |
|---|
| Histórico de alarmes revisado | ☐ |
| Alarmes recorrentes analisados | ☐ |
| Comunicação intermitente verificada | ☐ |
| Relatórios semanais conferidos | ☐ |
| Tamanho do banco avaliado | ☐ |
| Espaço em disco avaliado | ☐ |
| Logs principais revisados | ☐ |
| Backups conferidos | ☐ |
| Usuários temporários revisados | ☐ |
| Pendências de suporte atualizadas | ☐ |
A rotina semanal ajuda a identificar problemas antes que virem falhas graves.
Rotina mensal recomendada
Checklist mensal:
| Item | Verificado |
|---|
| Backup restaurável testado | ☐ |
| Banco de dados revisado | ☐ |
| Crescimento do histórico avaliado | ☐ |
| Certificados revisados, se aplicável | ☐ |
| DDNS ou acesso externo testado | ☐ |
| Relatórios mensais validados | ☐ |
| Alarmes mais recorrentes analisados | ☐ |
| Usuários e permissões revisados | ☐ |
| Atualizações pendentes avaliadas | ☐ |
| Documentação do projeto atualizada | ☐ |
A rotina mensal deve gerar um pequeno registro de saúde do sistema.
Monitoramento da comunicação
Monitore:
Sinais de problema:
A comunicação com máquinas é um dos pontos mais importantes do supervisório.
CLPs, medidores, remotas, NVRs, câmeras, gateways, estações hidrotelemétricas, bancos de dados externos, APIs e sistemas integrados.
- Valores congelados
- Falha de comunicação recorrente
- Alarmes de timeout
- Dados nulos
- Variáveis sem atualização
- Comunicação oscilando
- Relatórios com lacunas
Use Visualizar Variáveis para confirmar valores em tempo real.
Diagnóstico de comunicação intermitente
Possíveis causas:
Ações recomendadas:
Comunicação intermitente costuma ser mais difícil que falha permanente.
cabo de rede instável, switch com problema, fonte de alimentação oscilando, roteador travando, Wi-Fi inadequado, VPN instável, firewall encerrando sessão, equipamento reiniciando, timeout curto, scan muito agressivo, excesso de variáveis e rede industrial congestionada.
- Identificar horário da falha.
- Verificar se afeta uma máquina ou várias.
- Comparar com logs de rede.
- Avaliar perda de pacotes.
- Revisar scan cycle.
- Verificar alimentação dos equipamentos.
- Registrar recorrência.
- Ajustar configuração com critério.
Monitoramento do servidor
Verifique:
O servidor deve ser acompanhado como parte da operação.
uso de CPU, uso de memória, espaço em disco, serviços em execução, disponibilidade do SQL Server, disponibilidade do IIS, logs de erro, horário do sistema, sincronismo NTP, antivírus, atualizações do Windows e reinicializações inesperadas.
Um problema no servidor pode parecer problema do supervisório, mas a causa pode ser infraestrutura.
Espaço em disco
Monitore:
Sugestão de alerta:
| Espaço livre | Ação |
|---|
| Acima de 30% | Normal |
| Entre 15% e 30% | Acompanhar |
| Entre 10% e 15% | Planejar limpeza |
| Abaixo de 10% | Ação urgente |
| Abaixo de 5% | Risco crítico |
Históricos, relatórios, logs e backups podem consumir disco ao longo do tempo.
disco do sistema, pasta do projeto, pasta de relatórios, banco de dados, backups locais, logs antigos, arquivos temporários e imagens ou exportações.
Não deixe o servidor operar com disco quase cheio.
Banco de dados
Verifique periodicamente:
Verificações:
O banco de dados pode crescer conforme frequência de coleta, quantidade de variáveis, alarmes, eventos e relatórios.
tamanho do banco, tamanho dos arquivos de log, espaço livre em disco, desempenho de consultas, geração de relatórios, retenção de histórico, backups do banco, integridade do banco, permissões de usuário e conexão do projeto com o banco.
- Relatório lento
- Banco muito grande
- Log do SQL crescendo
- Sem espaço em disco
- Falha de conexão
- Histórico com lacunas
Retenção de dados
Exemplos:
| Tipo de dado | Retenção sugerida |
|---|
| Alarmes operacionais | conforme contrato ou requisito |
| CEPs | conforme necessidade de auditoria |
| Relatórios gerados | conforme exigência operacional/regulatória |
| Logs técnicos | menor retenção, salvo investigação |
| Backups | política específica |
| Dados hidrológicos | conforme exigência do cliente |
Defina com o cliente por quanto tempo os dados devem ser mantidos.
Sem política de retenção, o banco pode crescer indefinidamente.
Backups periódicos
Recomendações:
Backups devem ser rotina, não exceção.
- backup automático quando possível;
- backup manual antes de alterações;
- backup do projeto;
- backup do banco;
- cópia fora do servidor principal;
- teste periódico de restauração;
- registro de data e responsável;
- armazenamento seguro.
Um backup que nunca foi testado não deve ser considerado totalmente confiável.
Verificação dos backups
Verifique:
| Item | Verificação |
|---|
| Backup foi gerado | Sim/Não |
| Arquivo possui tamanho coerente | Sim/Não |
| Data está atual | Sim/Não |
| Local está acessível | Sim/Não |
| Banco foi incluído | Sim/Não |
| Projeto foi incluído | Sim/Não |
| Restauração foi testada | Sim/Não |
Backups automáticos podem falhar silenciosamente. Confira.
IIS e acesso Web
Verifique:
O IIS deve permanecer saudável para que o supervisório Web funcione.
site ativo, pool de aplicação ativo, porta correta, certificado válido, se HTTPS, permissões de pasta, logs do IIS, erros HTTP, acesso local, acesso pela rede e acesso externo, se aplicável.
Se o acesso local funciona e o acesso externo não funciona, investigue rede, firewall, NAT, DNS ou certificado.
Certificados e DDNS
Quando houver HTTPS, DDNS ou subdomínio, acompanhe:
Problemas típicos:
- validade do certificado;
- renovação automática;
- apontamento DNS;
- IP público;
- NAT;
- firewall;
- mudança de provedor de internet;
- bloqueio de portas;
- vencimento de domínio, quando aplicável.
- Certificado expirado
- Subdomínio apontando para IP antigo
- Roteador substituído sem refazer NAT
- Provedor mudou IP público
- Firewall bloqueou porta
Acesso remoto deve ser testado periodicamente.
Serviços e processos
Exemplos:
Verifique:
- se o serviço está ativo;
- se reiniciou recentemente;
- se há erro em log;
- se consome CPU ou memória excessiva;
- se está configurado para iniciar com o Windows.
Quando o ambiente usar serviços ou processos auxiliares, monitore se estão em execução.
runtime principal, serviço de monitoramento, serviço de relatórios, serviço de DDNS/certificado, SQL Server, IIS, tarefas agendadas, serviços de comunicação, integrações externas e monitor remoto.
Horário do servidor
Problemas causados por horário incorreto:
O horário do servidor deve estar correto.
- relatórios com horário errado;
- alarmes fora de ordem;
- CEPs com data incorreta;
- certificados inválidos;
- falha de autenticação;
- inconsistência em históricos;
- comparação incorreta de eventos.
Recomenda-se usar sincronização NTP confiável.
Logs
Locais possíveis:
Ao analisar um log, registre:
| Campo | Informação |
|---|
| Data/hora | Quando ocorreu |
| Serviço | Qual componente gerou |
| Mensagem | Texto do erro |
| Frequência | Único ou recorrente |
| Impacto | Afetou operação? |
| Ação | O que foi feito |
Logs ajudam a diagnosticar problemas.
logs do Flessor, logs do runtime, logs do IIS, logs do Windows, logs do SQL Server, logs de tarefas agendadas, logs de serviços auxiliares e logs de integração externa.
Não apague logs relevantes antes de concluir diagnóstico.
Alarmes sistêmicos
Exemplos:
Além dos alarmes de máquina, acompanhe alarmes sistêmicos.
- falha de banco de dados;
- falha de comunicação geral;
- falha de sincronismo;
- falha de envio de relatório;
- servidor sem espaço em disco;
- estação hidrotelemétrica sem atualização;
- NVR offline;
- serviço parado;
- erro de licença;
- falha de acesso externo.
Esses alarmes ajudam a identificar problemas de infraestrutura e integração.
Alarmes recorrentes
Exemplo:
Possíveis causas:
Ação recomendada:
Alarmes recorrentes merecem análise.
Falha de comunicação com CLP UG01 ocorre 15 vezes por dia.
rede instável, scan muito rápido, equipamento reiniciando, cabo ruim, switch com problema, timeout inadequado e driver mal configurado.
- Levantar frequência.
- Identificar horário.
- Verificar se há padrão.
- Consultar operação.
- Verificar rede.
- Ajustar configuração, se necessário.
- Registrar correção.
Não normalize alarme recorrente apenas aumentando delay sem entender causa.
Relatórios automáticos
Quando houver relatórios automáticos, verifique:
Verificações:
se foram gerados, se possuem dados, se o período está correto, se o envio por e-mail funcionou, se os anexos abriram, se o cabeçalho está correto, se os valores fazem sentido e se não há lacunas.
- Relatório gerado vazio
- E-mail não enviado
- Anexo corrompido
- Banco sem dados no período
- Variável removida do relatório
E-mail e notificações
Se o projeto envia e-mails ou notificações:
teste credenciais, teste servidor SMTP ou serviço usado, confirme destinatários, revise limites de envio, revise spam/bloqueio, confirme anexos, revise mensagens e confirme envio de alarmes críticos, se aplicável.
Notificações devem ser úteis. Excesso de mensagens reduz atenção.
Usuários e permissões
Revise periodicamente:
Boas práticas:
- remover usuários não usados;
- evitar conta compartilhada;
- usar níveis adequados;
- registrar quem tem acesso a comandos críticos;
- revisar permissões após mudanças de equipe.
usuários ativos, usuários temporários, usuários de integrador, senhas padrão, permissões de tela, permissões de comando, permissões de relatórios, acessos de manutenção e usuários desligados da empresa.
Segurança do acesso remoto
Se houver acesso remoto:
- preferir VPN ou método seguro aprovado;
- evitar exposição desnecessária de portas;
- usar HTTPS;
- manter senhas fortes;
- revisar usuários;
- revisar firewall;
- revisar logs de acesso;
- remover acessos temporários;
- documentar quem acessa e por quê.
Acesso remoto é útil para suporte, mas precisa ser controlado.
Atualizações do Windows
Cuidados:
Atualizações do sistema operacional podem ser necessárias, mas devem ser planejadas.
- agendar janela;
- fazer backup;
- avisar operação;
- verificar se o servidor pode reiniciar;
- testar IIS após atualização;
- testar SQL Server;
- testar runtime;
- testar comunicação com máquinas;
- registrar resultado.
Não permita reinicialização automática em horário crítico sem alinhamento com o cliente.
Antivírus e proteção do servidor
Verifique:
Antivírus pode afetar desempenho ou bloquear arquivos.
exclusões necessárias, quarentena, bloqueio de executáveis, bloqueio de scripts, bloqueio de portas, impacto em SQL Server, impacto em IIS e varreduras em horário crítico.
A política deve ser definida com TI do cliente.
Desempenho do supervisório
Sinais de desempenho ruim:
Possíveis causas:
Ação recomendada:
- Identificar onde está a lentidão.
- Separar problema de tela, banco, rede ou servidor.
- Medir antes de alterar.
- Corrigir gradualmente.
- Testar após cada ajuste.
telas lentas, login demorado, relatórios lentos, valores atrasados, navegador travando, CPU alta, memória alta, banco lento e disco em uso constante.
imagens muito pesadas, telas com muitos componentes, scan muito agressivo, banco grande, servidor subdimensionado, scripts JS pesados, excesso de alarmes ou eventos e rede instável.
Manutenção de telas
Exemplos:
Após a entrega, telas podem precisar de ajustes.
reposicionar valores, corrigir legenda, melhorar contraste, ajustar unidade, incluir novo indicador, corrigir variável, remover componente inútil, melhorar botão e incluir diagnóstico.
Toda alteração em tela deve ser registrada e versionada.
Manutenção de alarmes
Possíveis ajustes:
Alarmes devem ser revisados após uso real.
corrigir mensagem, ajustar delay, corrigir nível, adicionar causa e solução, remover falso alarme, separar alarme e trip, criar alarme sistêmico e revisar notificação.
Não desative alarme apenas porque incomoda. Primeiro investigue se ele está indicando problema real.
Manutenção de relatórios
Revise:
Relatórios podem exigir ajustes após primeiras entregas.
variáveis, unidades, período, cabeçalho, logotipo, agrupamentos, campos ausentes, excesso de informação, desempenho e envio automático.
Relatório deve atender quem usa a informação, não apenas quem configurou.
Manutenção de variáveis
Situações comuns:
Alterações no CLP, protocolo ou equipamento podem exigir revisão de variáveis.
CLP recompilado, símbolos alterados, endereço Modbus mudou, OID SNMP diferente, equipamento substituído, driver atualizado, variável removida e unidade corrigida.
Após qualquer alteração de variável, revise telas, alarmes, relatórios, Tags Virtuais, CEPs, horímetros e sincronismos associados.
Manutenção de comandos
Antes de alterar comando:
Comandos devem ser tratados com controle rigoroso.
confirmar solicitação, revisar risco, fazer backup, validar variável, validar permissão, validar confirmação, testar em condição segura e registrar alteração.
Comando alterado sem controle pode causar operação indevida.
Registro de atendimento
Modelo:
| Campo | Preenchimento |
|---|
| Data/hora | |
| Cliente | |
| Projeto | |
| Solicitante | |
| Tipo | Dúvida / Falha / Melhoria / Emergência |
| Descrição | |
| Diagnóstico | |
| Ação executada | |
| Arquivos alterados | |
| Versão antes | |
| Versão depois | |
| Responsável | |
| Status | Aberto / Em andamento / Resolvido |
| Observações | |
Todo atendimento deve ser registrado.
Esse registro protege o integrador e melhora suporte futuro.
Classificação de chamados
| Criticidade | Exemplo | Prazo sugerido |
|---|
| Baixa | ajuste visual, dúvida simples | conforme contrato |
| Média | relatório incorreto, tela com dado secundário errado | curto prazo |
| Alta | perda de comunicação com máquina importante | atendimento prioritário |
| Crítica | supervisório indisponível, comando crítico com erro | atendimento imediato |
Classifique chamados por criticidade.
O prazo real depende do contrato de suporte.
Atendimento remoto
Antes de atendimento remoto:
confirmar autorização, registrar horário, confirmar escopo, fazer backup antes de alterar, evitar mudanças sem registro, não testar comando sem responsável local, registrar o que foi feito e informar conclusão.
Acesso remoto deve ser usado com responsabilidade.
Atendimento em campo
Em atendimento presencial, leve:
notebook com Studio, backup mais recente, instalador compatível, documentação do projeto, lista de IPs, credenciais autorizadas, cabos de rede, adaptador USB/RJ45, acesso ao servidor, contato da operação, contato da automação e plano de testes.
Após atendimento, gere relatório técnico simples.
Relatório de suporte
Modelo de relatório:
| Campo | Preenchimento |
|---|
| Cliente | |
| Unidade | |
| Data | |
| Responsável | |
| Motivo do atendimento | |
| Diagnóstico | |
| Ação executada | |
| Testes realizados | |
| Resultado | |
| Pendências | |
| Recomendações | |
Esse relatório pode ser enviado ao cliente após intervenção relevante.
Indicadores de saúde do sistema
Exemplos:
| Indicador | Objetivo |
|---|
| Disponibilidade do supervisório | Saber se o sistema está acessível |
| Máquinas online | Monitorar comunicação |
| Alarmes críticos ativos | Identificar risco |
| Falhas de comunicação por dia | Identificar instabilidade |
| Tempo de geração de relatório | Avaliar desempenho |
| Espaço livre em disco | Evitar parada por disco cheio |
| Último backup válido | Garantir recuperação |
| Uso de CPU/memória | Avaliar servidor |
| Última atualização de hidrotelemetria | Verificar dados externos |
É útil acompanhar indicadores simples.
Esses indicadores podem ser exibidos em uma tela de diagnóstico.
Tela de diagnóstico do sistema
Conteúdo sugerido:
Recomenda-se criar uma tela de diagnóstico administrativo.
status do servidor, status do banco, status do IIS, comunicação das máquinas, falhas de sincronismo, status de relatórios, espaço em disco, última atualização de dados, status de NVR/câmeras, status de hidrotelemetria, versão do projeto, data do último backup e usuários conectados, quando disponível.
Essa tela deve ter permissão adequada.
Pendências pós-entrega
Registre:
| Campo | Preenchimento |
|---|
| Pendência | |
| Tipo | Correção / Melhoria / Aguardando cliente |
| Responsável | |
| Prazo | |
| Impacto | Baixo / Médio / Alto |
| Status | Aberta / Em andamento / Resolvida |
| Observação | |
Nem toda entrega termina sem pendências.
Pendência não registrada tende a virar conflito futuro.
Revisão periódica com o cliente
Pauta sugerida:
Agende revisões periódicas quando houver contrato de suporte.
principais alarmes do período, falhas de comunicação, relatórios gerados, solicitações de melhoria, usuários e permissões, backups, desempenho, necessidade de atualização, pendências abertas e riscos identificados.
Essa reunião pode ser mensal ou trimestral.
Atualizações planejadas
Antes de atualizar:
Atualizações devem seguir processo.
registrar motivo, revisar impacto, fazer backup, testar em homologação, quando possível, agendar janela, avisar operação, preparar rollback, aplicar alteração, testar e registrar conclusão.
Evite atualizações improvisadas em produção.
Melhorias evolutivas
Exemplos:
Após a entrada em operação, o cliente pode solicitar melhorias.
novas telas, novos relatórios, novos alarmes, dashboards, integração com câmera, integração com API, novos usuários, novas permissões, novas máquinas, análise preditiva e telas de manutenção.
Trate melhoria como nova demanda, com escopo, prazo e validação.
Não misturar suporte com alteração de escopo
Diferencie:
| Situação | Classificação |
|---|
| Valor aparece errado por escala configurada errada | Correção |
| Cliente quer nova tela | Melhoria |
| Cliente quer novo relatório | Melhoria |
| Comunicação caiu por switch queimado | Suporte/infraestrutura |
| CLP mudou tags sem avisar | Ajuste técnico |
| Botão comanda variável errada | Correção crítica |
| Operador esqueceu senha | Suporte operacional |
Essa distinção evita desgaste contratual.
Encerramento de chamado
Antes de encerrar:
- Confirmar que o problema foi resolvido.
- Testar com usuário ou responsável.
- Registrar alteração.
- Atualizar versão, se aplicável.
- Gerar backup, se houve mudança.
- Informar o cliente.
- Registrar pendências remanescentes.
Não encerre chamado apenas porque a alteração foi feita. Encerre após validação.
Diagnóstico rápido
Supervisório indisponível
Possíveis causas:
Ações recomendadas:
IIS parado, servidor desligado, runtime parado, firewall bloqueando, certificado com problema, porta ocupada, falha de licença, atualização do Windows e disco cheio.
- Testar acesso local.
- Verificar IIS.
- Verificar serviços.
- Verificar logs.
- Verificar disco.
- Verificar licença.
- Restaurar serviço ou acionar rollback.
Valores pararam de atualizar
Possíveis causas:
Ações recomendadas:
máquina sem comunicação, rede industrial com falha, driver parado, CLP desligado, IP alterado, firewall bloqueando e variável removida.
- Abrir Visualizar Variáveis.
- Verificar comunicação da máquina.
- Testar rede.
- Conferir IP e porta.
- Verificar CLP/equipamento.
- Registrar ocorrência.
Relatórios deixaram de ser gerados
Possíveis causas:
Ações recomendadas:
banco indisponível, serviço parado, tarefa agendada falhou, período sem dados, e-mail bloqueado, template alterado e falta de permissão na pasta.
- Verificar banco.
- Verificar logs.
- Testar relatório manual.
- Verificar tarefa ou serviço.
- Conferir template.
- Corrigir e registrar.
Backup não existe ou falhou
Possíveis causas:
Ações recomendadas:
rotina não configurada, disco cheio, permissão insuficiente, caminho indisponível, serviço de backup falhou e arquivo bloqueado.
Criar backup manual imediato, Corrigir rotina, Testar geração, Testar restauração e Registrar falha.
Acesso remoto parou
Possíveis causas:
Ações recomendadas:
IP público mudou, DDNS falhou, certificado expirou, NAT removido, roteador trocado, firewall alterado e VPN desconectada.
- Testar acesso interno.
- Testar DNS.
- Verificar certificado.
- Verificar NAT.
- Verificar firewall.
- Validar com TI.
Boas práticas
Adote as seguintes práticas:
- acompanhar o sistema após o deploy;
- manter rotina diária, semanal e mensal;
- monitorar comunicação das máquinas;
- revisar alarmes recorrentes;
- conferir backups;
- monitorar banco e disco;
- revisar IIS e acesso Web;
- manter usuários atualizados;
- registrar atendimentos;
- não alterar produção sem backup;
- separar correção de melhoria;
- manter documentação atualizada;
- validar alterações com o cliente;
- gerar backup após correções importantes.
Checklist de manutenção pós-entrega
| Item | Verificado |
|---|
| Supervisório acessível | ☐ |
| IIS ativo | ☐ |
| SQL Server ativo | ☐ |
| Banco acessível | ☐ |
| Espaço em disco adequado | ☐ |
| Comunicação com máquinas validada | ☐ |
| Visualizar Variáveis conferido | ☐ |
| Alarmes ativos revisados | ☐ |
| Alarmes recorrentes analisados | ☐ |
| Relatórios gerados | ☐ |
| E-mails/notificações funcionando | ☐ |
| Backup recente confirmado | ☐ |
| Restauração de backup testada periodicamente | ☐ |
| Usuários revisados | ☐ |
| Permissões revisadas | ☐ |
| Acesso remoto testado | ☐ |
| Certificado/DDNS revisado, quando aplicável | ☐ |
| Logs revisados | ☐ |
| Pendências registradas | ☐ |
| Documentação atualizada | ☐ |
Verificação inicial da instalação
Registre o estado do Studio, do Console, do IIS e do SQL Server antes de intervir. Teste o acesso web e a comunicação de cada máquina separadamente: um serviço em execução não garante conexão com os dispositivos de campo.
Antes de reiniciar serviços ou alterar configurações, preserve os logs, confira o backup e combine a intervenção com a operação.
Referência: Rotina de Manutenção e Suporte Pós-Entrega, do manual do integrador.